مصممون وباحثون يبتكرون خطوطاً لحماية النصوص من جمعها بواسطة الذكاء الاصطناعي
مصممون وباحثون يبتكرون خطوطاً لحماية النصوص من جمعها بواسطة الذكاء الاصطناعي
يعمل مصممون وباحثون في مجال التكنولوجيا على تطوير خطوط وأساليب بصرية جديدة تهدف إلى الحد من قدرة أنظمة الذكاء الاصطناعي وبرمجيات جمع البيانات على قراءة النصوص البشرية واستخدامها، في ظل تصاعد المخاوف بشأن الخصوصية واستعمال المحتوى المنشور في تدريب النماذج الذكية.
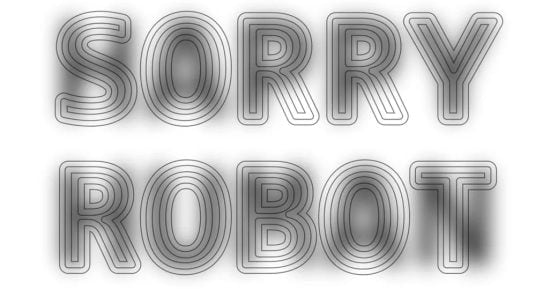
ومن بين هذه الابتكارات «Decoy Font»، أو «الخط الخداعي»، الذي يعتمد على تقنية مستوحاة من مفهوم «الصور الهجينة»، حيث يدمج طبقتين مختلفتين من النص بطريقة تسمح للإنسان بقراءة رسالة واضحة، في حين تظهر أمام الأنظمة الآلية معلومات بصرية مشوشة أو مختلفة.
وتعود فكرة الصور الهجينة إلى تجارب بصرية اشتهرت عام 2007، عندما قدم باحثون في معهد ماساتشوستس للتكنولوجيا «MIT» صورة تجمع ملامح مارلين مونرو وألبرت أينشتاين، بحيث تتغير الصورة التي يدركها الإنسان تبعاً للمسافة التي ينظر منها إليها.
وبحسب مجلة «سميثسونيان» الأميركية، فإن تطوير الخطوط الخداعية الجديدة يأتي هذه المرة مدفوعاً باعتبارات تتعلق بالخصوصية وحماية المحتوى البشري من القراءة والجمع الآليين.
وكانت شركة «MixFont» قد طورت تجربة سابقة حملت اسم «Ghost Font»، أو «الخط الشبح»، تقوم على عرض كلمات متحركة فوق خلفية متغيرة تشبه تشويش شاشات التلفاز، بهدف إرباك قدرة أنظمة الذكاء الاصطناعي على إدراك النصوص.
وقال مؤسس الشركة إريك لو إن فكرة المشروع جاءت بعد ملاحظته محاولة أدوات الذكاء الاصطناعي تلخيص الرسائل النصية المتبادلة بينه وبين والدته، وهو ما أثار لديه مخاوف بشأن تدخل هذه التقنيات في المحادثات الخاصة ودفعه إلى البحث عن طرق للتواصل يصعب على الأنظمة الآلية قراءتها.
وفي تجربة أخرى، أطلقت مجموعة من استوديوهات التصميم، بينها «Seneda & Abrucio» و«PlayType»، خطاً باسم «ShieldFont»، صُمم للتشويش على برمجيات جمع البيانات والزواحف الآلية.
وتقوم التقنية، بحسب القائمين عليها، باستبدال نحو نصف الكلمات ذات المحتوى، مثل الأسماء والأفعال والصفات والظروف، بكلمات عشوائية داخل الشفرة المصدرية للخط، بحيث تحصل برمجيات جمع البيانات على نصوص غير مترابطة، بينما يبقى المحتوى الأصلي قابلاً للقراءة أمام المستخدم البشري.
ووفقاً لمجلة «Fast Company»، فإن أكثر من 90% من النصوص المشوشة الناتجة عن هذه العملية ترفضها مرشحات الجودة المستخدمة في عمليات جمع البيانات.
ويرى مطورو هذه التقنيات أن الهدف الأساسي منها يتمثل في منح الكُتّاب والمبدعين قدراً أكبر من السيطرة على أعمالهم، وسط الجدل المتزايد بشأن جمع النصوص المنشورة واستخدامها في تدريب نماذج الذكاء الاصطناعي من دون علم أصحابها أو الحصول على موافقتهم.